用形状理解Transformer前向传播
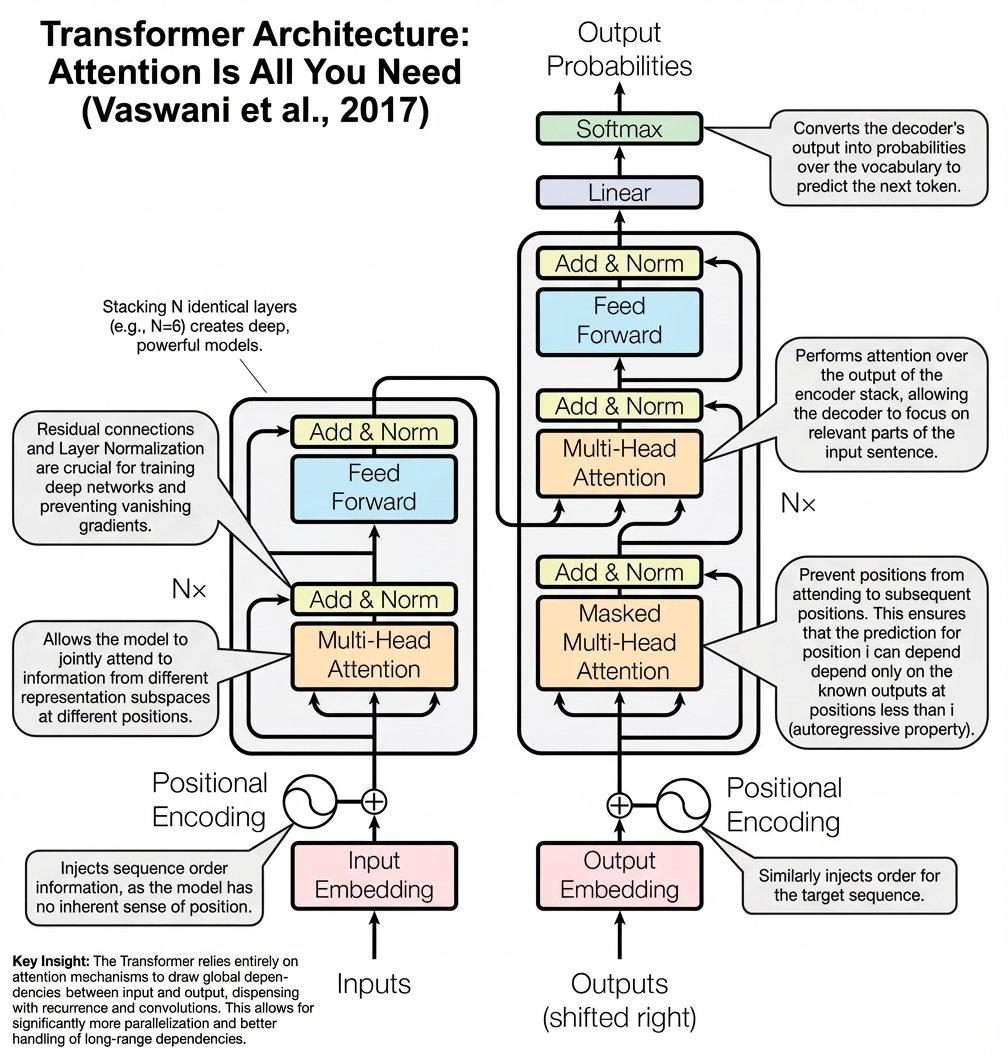
假设inputs的形状是[2,4],可以理解为两句话,每句话有4个token,输入到embedding层之后变为[2,4,512],每个token用512维特征表示。
经过位置编码后形状还是[2,4,512],只是加入了位置信息,经典的位置编码使用的是三角函数:
进入编码器,论文中要依次经过6个位置编码器,这里只梳理一个编码器的前向传播,其他同理。
首先经过多头自注意力层,三条线分别表示QKV(query、key、value),Q=K=V=位置编码层输出结果。引出的线的数据块同样等于Q,后面做残差连接时要用到。
进行多头注意力计算,
 # 注意力计算函数
    def attention(self, query, key, value, mask=None, dropout=None):
        d_k = query.size(-1)
        scores = torch.matmul(query, key.transpose(-1, -2)) / math.sqrt(d_k)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        # 计算注意力权重
        p_attn = F.softmax(scores, dim=-1)
        if dropout:
            p_attn = dropout(p_attn)
        return torch.matmul(p_attn, value)
掩码多头自注意力层
在编码器中不使用mask编码,QKV形状都是[2,4,512],使用QK*相乘,(K*=K的后两个维度交换,即[2,512,4]),故scores的形状为[2,4,4],还记得“4”嘛,指的一句话有4个token。所以对于[4,4]可以理解为一句话中的各个词与各个词的相关程度。
举个栗子,假设在英译汉的数据集上训练,这两句话其中一句话的4个token为 "I love you too" ,那么[4,4]矩阵就是
这时,只对最后一个维度进行softmax也不难理解。之后变成
每行和为1或1的近似值(1.002 or 0.9999)。
最后返回p_attn与V的相乘结果,即[2,4,4]X[2,4,512]=[2,4,512]。
总之,自注意力计算就是要看自己本身每个token与自己本身每个token的关系,并且由于矩阵运算天然的并行性,效率很高。
计算完成后,要进行残差连接与标准化。
残差连接很简单,输出等于[2,4,512]+[2,4,512]
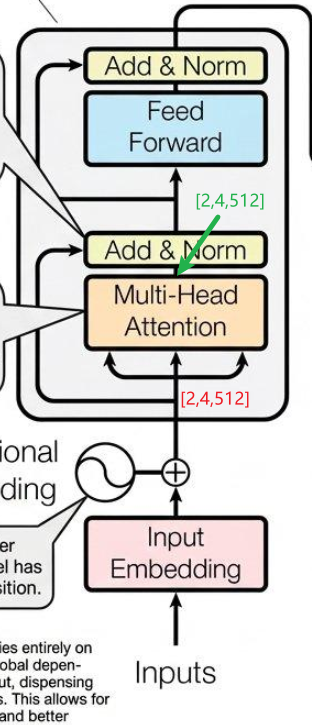
LayerNorm(标准化)就是对每个 token 的特征维度进行标准化,使其具有接近 0 的均值和 1 的方差,然后通过可学习参数进行缩放和偏移:
即 减均值、除标准差、缩放、平移。
之后进入前馈全连接,
# 前馈全连接层
class FeedForward(nn.Module):
    def __init__(self, d_model, d_ff, dropout_p=0.1):
        super().__init__()
        self.linear1 = nn.Linear(d_model, d_ff)
        self.linear2 = nn.Linear(d_ff, d_model)
        self.dropout = nn.Dropout(p=dropout_p)

    def forward(self, x):
        return self.linear2(self.dropout(F.relu(self.linear1(x))))
要做的也比较简单,通过两个全连接层,先把特征映射到高维,再映射回低维,第二个全连接层使用激活函数进行非线性变换,来学习更多的关系。假设d_ff=1024,形状变化为[2,4,512]->[2,4,1024]->[2,4,512] 。
同样的,进行残差连接与标准化。
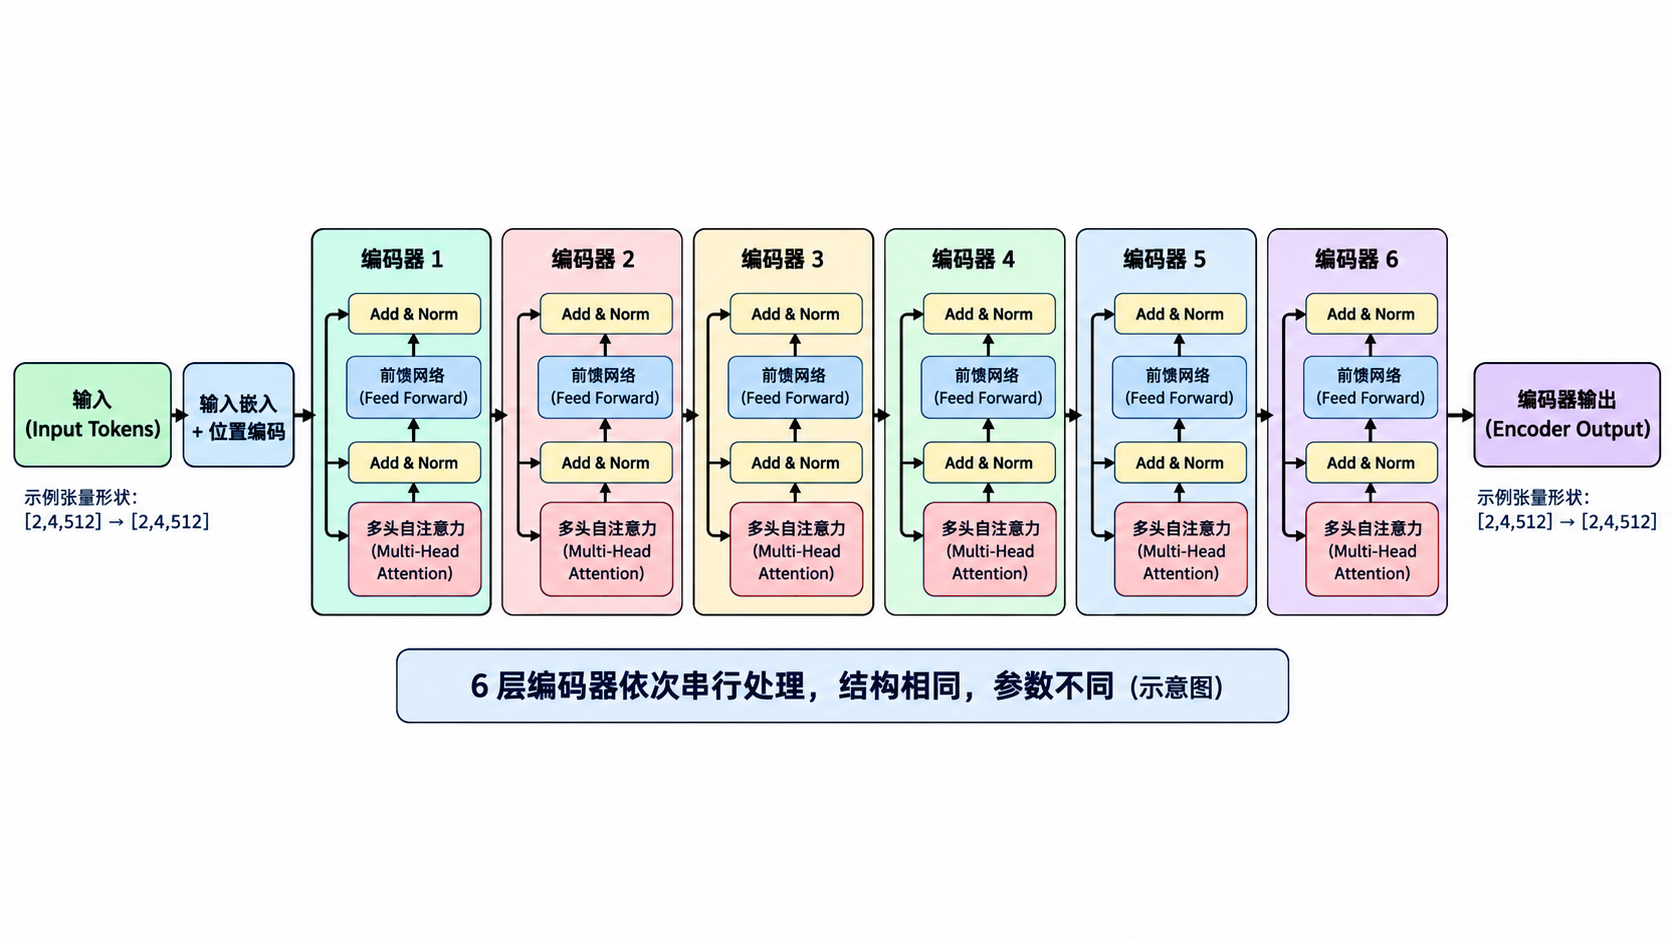
编码器就是这样,6层编码器层也只是依次进行,要做的事情一样,下面的图帮助理解:
开始对解码器层的梳理,这里主要是对训练过程中的前向传播进行梳理。输入需要是翻译后的正确结果,假设同样为[2,4]两句话,其中一句话的4个token就是“我 也 喜欢 你”。
经过embedding层和位置编码层,此时形状为[2,4,512]。
之后进入掩码多头自注意力层,进行掩码多头自注意力计算,回顾一下前面的注意力计算函数,
 # 注意力计算函数
    def attention(self, query, key, value, mask=None, dropout=None):
        d_k = query.size(-1)
        scores = torch.matmul(query, key.transpose(-1, -2)) / math.sqrt(d_k)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        # 计算注意力权重
        p_attn = F.softmax(scores, dim=-1)
        if dropout:
            p_attn = dropout(p_attn)
        return torch.matmul(p_attn, value)
与编码器的注意力计算区别就是多了掩码,mask不再为None。scores的形状为[2,4,4],只考虑一个[4,4]矩阵,
,还记得这个矩阵的含义嘛(忘记了看前面)?
经过掩码覆盖 变为 。为什么要这样干嘞,因为我们想训练解码器,最终是要用训练好的模型来完成翻译任务的,所以解码器在预测阶段并不能看到翻译好的 “我 也 喜欢 你” 。于是我们在训练阶段就使用mask的方式遮掉后面的内容。看矩阵第一行,比如在生成“也”时,解码器看不到后面的答案,只能根据“我”对下一个token(“也”)进行预测,所以矩阵第一行才为[2.0 0 0 0]。
在解码器部分我们已经说了,注意力计算是并行的,所以这里我们才使用mask把整个[4,4]处理成下三角矩阵的形式。
输出为[2,4,512],之后进行残差连接和标准化。
接下来进入多头注意力机制层,注意,不是自注意力机制了。Q是上一个模块(掩码多头自注意力层、残差连接和标准化)的输出,K=V=编码器的输出,回顾下注意力机制函数,
 # 注意力计算函数
    def attention(self, query, key, value, mask=None, dropout=None):
        d_k = query.size(-1)
        scores = torch.matmul(query, key.transpose(-1, -2)) / math.sqrt(d_k)

        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        # 计算注意力权重
        p_attn = F.softmax(scores, dim=-1)
        if dropout:
            p_attn = dropout(p_attn)
        return torch.matmul(p_attn, value)
这个函数还是复用的,只是传入参数变了。这里mask还是None。
这一步可以理解为,查询 Q(待生成token的矩阵表示)与原文本各token的K的关系,之后把这个关系程度转换为概率,再与原文本各token的V相乘。同样的,之后进行残差连接和标准化。
最后的模块(前馈全连接、残差连接和标准化)与编码器的相同,不重复介绍了。
输出的形状为[2,4,512]。
解码器层介绍完了,这一层一般也是几层串起来的,一般为6层。唯一不好理解的点可能是编码器KV的输入是怎样输入的,其实是并行同时输入到各解码器层的多头注意力层参与计算的。
最后过一个全连接层,通过softmax映射为词表概率,概率最高的就是预测出来的token。
文章作者:shuimqy
文章链接:http://124.222.238.77:8090//archives/yong-xing-zhuang-li-jie-transformerqian-xiang-chuan-bo
版权声明:本博客所有文章除特别声明外,均采用CC BY-NC-SA 4.0 许可协议,转载请注明出处!
评论已关闭!